Architektura Microsoft Fabric i Power BI łączy procesy zasilania, przechowywania i przygotowania danych z warstwą analityczną wykorzystywaną przez biznes. Fabric zapewnia wspólne środowisko pracy z danymi, a Power BI odpowiada za modele semantyczne i raportowanie. Nie oznacza to jednak, że wszystkie operacje powinny być wykonywane w jednym narzędziu albo że każdy projekt potrzebuje wszystkich komponentów platformy.
Warstwy architektury Fabric i Power BI
Typowy przepływ danych obejmuje kilka etapów. Ich rozdzielenie pozwala diagnozować błędy, niezależnie rozwijać raporty i ponownie wykorzystywać dane w innych obszarach analityki.
- Źródła danych. Systemy transakcyjne, np. SAP HANA działający lokalnie, oraz pliki CSV, JSON i XLSX dostarczają danych do analizy. Na początku trzeba określić sposób dostępu, częstotliwość pobierania i zakres historii.
- Integracja i orkiestracja. Data Factory w Microsoft Fabric umożliwia budowanie procesów pobierania i przesyłania danych. Przy połączeniu z lokalnym SAP HANA potrzebna jest właściwie skonfigurowana brama danych i obsługiwany sterownik. W zależności od źródła można korzystać także z innych metod udostępniania danych.
- Przechowywanie. OneLake jest wspólną logiczną warstwą przechowywania dla Fabric. Dane mogą trafiać m.in. do Lakehouse lub Warehouse, których sposób pracy dobiera się do charakteru projektu.
- Transformacja i kontrola jakości. Notebooki, przepływy danych i operacje SQL służą do oczyszczania, uzgadniania i przygotowania danych. W środowisku Lakehouse można je porządkować w warstwach Bronze, Silver i Gold.
- Model semantyczny i raportowanie. Model Power BI definiuje relacje, miary i zasady dostępu. Dopiero z tej warstwy raporty udostępniają uzgodnione wskaźniki użytkownikom.
Schemat architektury na przykładzie SAP HANA
Na poniższym schemacie dane z SAP HANA oraz plików lokalnych są pobierane do środowiska analitycznego, przetwarzane w kilku warstwach i udostępniane w Power BI. To przykład rozwiązania, a nie obowiązkowa konfiguracja każdej implementacji Fabric.
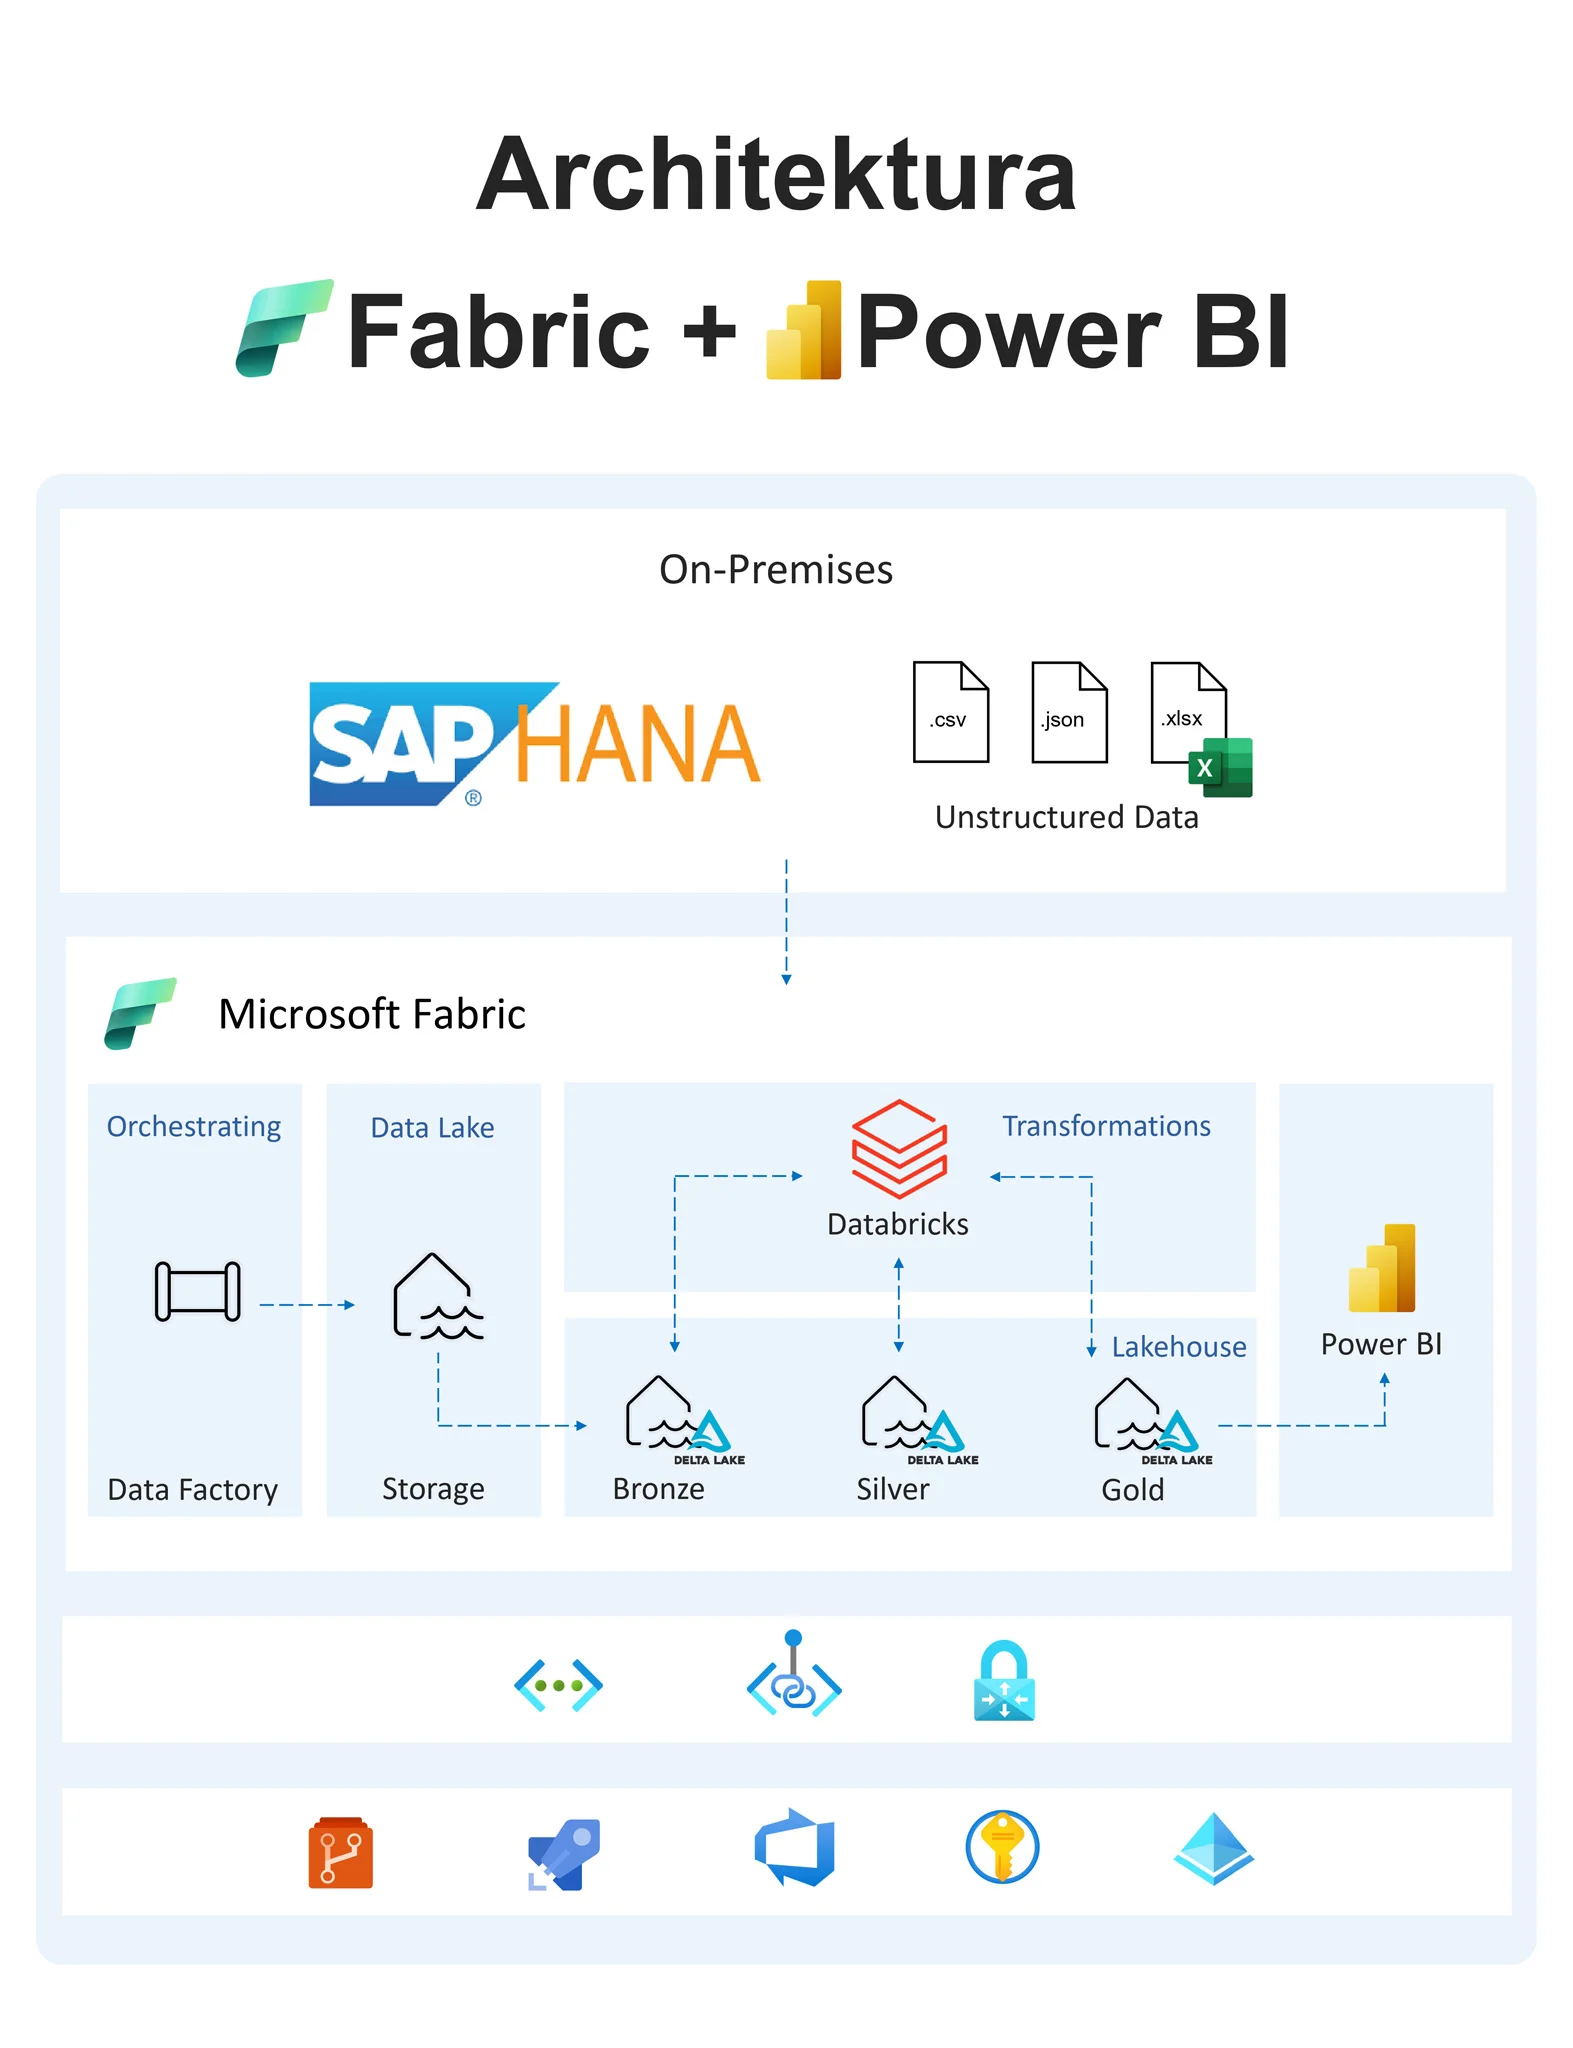
Ważne przy interpretacji schematu: Azure Databricks jest odrębną usługą Azure, którą można zintegrować z Fabric, a nie jego wbudowanym modułem. Pliki CSV i XLSX zawierają zwykle dane ustrukturyzowane, a JSON dane półustrukturyzowane. Opis „Unstructured Data” na grafice jest w tym przypadku uproszczeniem.
Bronze, Silver, Gold - jak przygotować dane?
Wzorzec Medallion porządkuje przetwarzanie danych według stopnia ich przygotowania. Rozdziela dane otrzymane ze źródeł od danych oczyszczonych oraz od struktur używanych bezpośrednio w analityce.
- Bronze. Dane możliwie zbliżone do źródła, zachowane z informacją o pochodzeniu i czasie pobrania. Ułatwiają ponowne przetworzenie lub wyjaśnienie rozbieżności.
- Silver. Dane poddane walidacji, deduplikacji i standaryzacji. Na tym etapie można np. uzgodnić identyfikatory kontrahentów oraz formaty dat z różnych systemów.
- Gold. Dane przygotowane pod konkretne zastosowania biznesowe, np. analizę sprzedaży, rentowności lub realizacji zamówień.
Warstwy nie muszą być osobnymi fizycznymi magazynami. Sposób ich wydzielenia zależy od wymagań związanych z bezpieczeństwem, utrzymaniem i skalą. W wielu projektach dane w warstwach Silver i Gold są przechowywane jako tabele Delta.
Lakehouse czy Warehouse? Kryteria wyboru
Lakehouse sprawdzi się, gdy projekt obejmuje różne formaty danych, notebooki i przetwarzanie w Apache Spark. Warehouse jest często wygodniejszy dla zespołu pracującego w T-SQL, który tworzy relacyjne struktury analityczne i potrzebuje rozbudowanych operacji SQL.
To nie są rozwiązania wykluczające się. Można przygotować dane w Lakehouse, a następnie wykorzystać Warehouse do warstwy analitycznej. W obu przypadkach przechowywanie opiera się na OneLake i otwartym formacie Delta. Należy przy tym pamiętać, że punkt końcowy SQL Lakehouse nie ma tego samego zakresu operacji zapisu co Warehouse.
Przykład decyzji: jeśli głównym zadaniem jest wczytanie danych z SAP HANA, oczyszczenie plików JSON i przygotowanie wieloetapowych transformacji w Spark, naturalnym kandydatem jest Lakehouse. Jeżeli końcowy model danych ma być rozwijany przede wszystkim w T-SQL, warto rozważyć również Warehouse.
Model semantyczny i dostęp do danych w Power BI
Warstwa Gold nie zastępuje modelu semantycznego. To w modelu Power BI definiuje się relacje między tabelami, miary DAX (Data Analysis Expressions), formaty oraz reguły widoczności danych. Dobrze zaprojektowany model pozwala wielu raportom korzystać z tej samej definicji przychodu, kosztu lub marży, bez powielania logiki w każdym raporcie.
Przy projektowaniu połączenia trzeba wybrać odpowiedni tryb pracy. Import przechowuje kopię danych w modelu; DirectQuery kieruje zapytania do źródła; Direct Lake pozwala modelowi odczytywać dane z tabel Delta w OneLake bez klasycznego importowania całych tabel. Direct Lake nie znosi potrzeby kontroli aktualności danych - wykorzystuje mechanizm aktualizacji metadanych tabel, a jego dostępność i zachowanie zależą od konfiguracji i pojemności Fabric.
Ponowne wykorzystanie danych bez kolejnych silosów
Jedną z najważniejszych decyzji projektowych jest oddzielenie danych wspólnych dla organizacji od logiki właściwej tylko jednemu raportowi. Dane przygotowane raz można wykorzystać w kilku modelach semantycznych, raportach i innych procesach, jeśli pozwalają na to zakres uprawnień oraz definicje biznesowe.
W Fabric pomocne są m.in. shortcuts w OneLake, które umożliwiają odwoływanie się do wybranych danych bez konieczności ich kopiowania. Nie eliminują one potrzeby sprawdzenia uprawnień, wydajności ani jakości danych źródłowych. Korzyść z ponownego użycia pojawia się dopiero wtedy, gdy wiadomo, kto odpowiada za wspólne dane i jak są aktualizowane.
Bezpieczeństwo, wydajność i utrzymanie
Wspólna platforma nie zwalnia z projektowania zabezpieczeń. Należy oddzielnie kontrolować dostęp do połączeń i magazynów danych, obszarów roboczych Fabric oraz modeli semantycznych Power BI. Row-Level Security (RLS) w modelu może ograniczać widoczne wiersze, ale nie zastępuje zabezpieczeń na poziomie OneLake czy innych ścieżek dostępu do danych.
W środowisku produkcyjnym znaczenie mają również monitoring procesów Data Factory, testy jakości danych, wersjonowanie, wdrażanie zmian między środowiskami oraz obserwowanie zużycia pojemności Fabric. Często to błędny harmonogram zasilania, nieefektywne transformacje lub źle zaprojektowany model semantyczny są przyczyną opóźnień, a nie samo narzędzie raportowe.
Praktyczny punkt kontrolny: przed udostępnieniem danych użytkownikom warto potwierdzić, kiedy aktualizują się tabele Gold, kiedy zmiany są widoczne w modelu Power BI i kto otrzymuje powiadomienie w przypadku nieudanego zasilania.
Najczęstsze pytania o Fabric i Power BI
Czy do korzystania z Power BI trzeba wdrożyć Microsoft Fabric?
Nie. Power BI może działać z istniejącą hurtownią danych, bazą SQL lub innymi źródłami. Microsoft Fabric warto rozważyć, gdy projekt wymaga wspólnego środowiska integracji, przechowywania i przygotowania danych.
Kiedy wybrać Lakehouse, a kiedy Warehouse w Microsoft Fabric?
Lakehouse jest naturalnym wyborem dla danych o różnych formatach i przetwarzania w Apache Spark, na przykład w układzie Bronze, Silver i Gold. Warehouse lepiej pasuje do relacyjnej analityki i pracy przede wszystkim w T-SQL. Oba podejścia można połączyć.
Czy Direct Lake całkowicie eliminuje odświeżanie modelu Power BI?
Nie w każdym znaczeniu. Direct Lake nie wymaga kopiowania całych danych do modelu w sposób charakterystyczny dla Import, ale model musi aktualizować metadane wskazujące wersje tabel Delta. Proces ten może odbywać się automatycznie lub być sterowany.
Czy Azure Databricks jest częścią Microsoft Fabric?
Nie. Azure Databricks to odrębna usługa Azure, którą można zintegrować z architekturą opartą na Microsoft Fabric i OneLake. Do typowych transformacji nie trzeba jednak wdrażać Databricks, ponieważ Fabric oferuje własne narzędzia do przetwarzania danych.
Dokumentacja techniczna Microsoft
Szczegółowe możliwości usług i ograniczenia trybów połączenia warto sprawdzać w bieżącej dokumentacji:
Powiązane materiały
Potrzebujesz wdrożenia lub audytu?
MicrosoftBI wyjaśnia podejście i architekturę. Jeżeli chcesz przejść do realizacji, sprawdź usługę Antdata odpowiadającą temu obszarowi.
Wdrożenia Microsoft Fabric w Antdata →